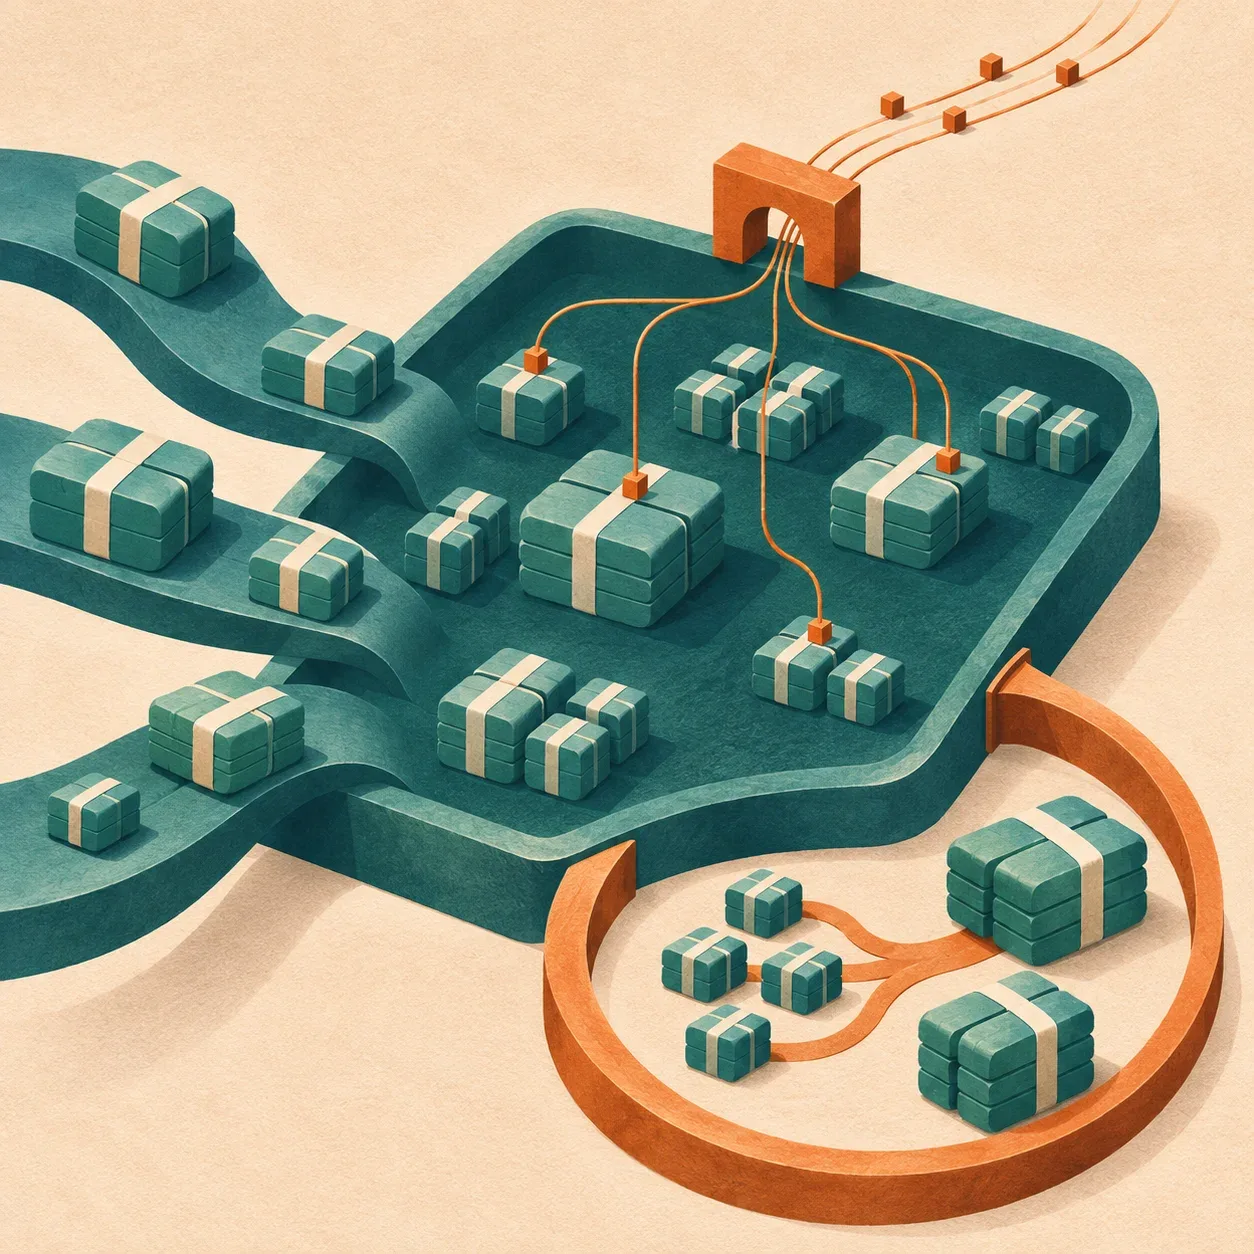
하나의 저장소에서 수천 에이전트가 코드를 바꾸면, Git 서버는 변경을 받아 저장하는 일만 바빠지는 게 아니다. 푸시가 들어오면 CI가 실행되고, 배포 시스템이 새 커밋을 가져가며, 다른 에이전트도 작업 맥락을 얻기 위해 이를 읽는다. 쓰기가 늘수록 뒤따르는 읽기도 늘어난다.
GitHub가 11월 5일 공개한 새 Git 저장 아키텍처는 이런 단일 저장소의 집중 부하를 겨냥한다. GitHub는 내부 시험에서 한 저장소에 동시 에이전트 5,000개가 작업하며 초당 푸시 7,200회를 보내는 동안에도 낮은 읽기 지연을 유지했다고 밝혔다. 이 규모를 받치는 설계의 출발점은 푸시 안에서 함께 순서를 정해야 하는 부분을 좁히는 것이다.
데이터 저장과 브랜치의 이동을 나누다
Git 객체는 한 번 만들어지면 바뀌지 않고, 내용으로 식별된다. 두 작업자가 객체를 저장할 때 서로 누가 먼저인지 합의할 필요가 없다. 반면 브랜치가 어느 커밋을 가리키는지 나타내는 참조는 계속 바뀐다. 같은 참조를 두 작업자가 갱신하려 하면, 어떤 변경을 받아들일지 정해야 한다.
GitHub는 이 차이에 맞춰 영속 상태를 두 곳에 나눴다. 객체를 묶은 파일인 팩은 Azure Blob Storage에 둔다. 참조와 저장소를 구성하는 팩 목록은 별도의 복제 로그 서비스인 Ref-CAS가 맡는다. 큰 객체 데이터를 저장하는 일과 작은 참조 변경의 순서를 정하는 일이 분리된다.
클라이언트 요청을 실제로 처리하는 쪽은 ‘가상 복제본’이다. 가상 복제본의 로컬 디스크는 언제든 다시 만들 수 있는 캐시다. 특정 복제본에 요청이 도착해야만 데이터가 올바르게 유지되는 구조가 아니므로, 저장소가 바빠지면 복제본을 더 붙일 수 있다. 복제본 하나가 사라지면 다른 복제본이 요청을 계속 처리하고, 새 복제본은 트래픽을 받으며 캐시를 채운다.
이 구성에서 쓰기와 읽기는 다음처럼 흐른다. 유지보수는 별도 노드가 맡는다.
각 경로는 역할별 흐름이다. 같은 시점에 시작하거나 끝난다는 뜻은 아니다. 유지보수는 이미 저장된 팩을 대상으로 한다.
쓰기 요청
- 가상 복제본들어온 팩의 인덱스를 만든다.
- Azure Blob Storage팩을 먼저 업로드해 객체를 영속 저장한다.
- Ref-CAS한 트랜잭션으로 팩 목록에 팩을 등록하고 참조를 갱신한다.
읽기 요청
- 가상 복제본 → Ref-CAS캐시에 가진 참조 버전이 최신인지 확인한다.
- Azure Blob Storage → 캐시요청 처리에 필요한 팩을 가져온다.
- 가상 복제본캐시에서 읽기 요청을 처리한다.
별도 유지보수 노드
- 팩 병합Blob Storage의 팩을 합쳐 조회 비용이 계속 늘지 않도록 한다.
- Ref-CAS에 변경 반영변경된 팩 목록을 통해 가상 복제본에 새 저장 상태를 알린다.
쓰기 순서에는 안전성을 위한 조건이 있다. 참조가 가리키는 객체는 참조 변경을 확정하기 전에 이미 영속 저장돼 있어야 한다. Ref-CAS는 객체 자체를 보관하거나 검증하지 않고 그 위치를 가리키는 정보만 관리한다.
참조 갱신에서는 해당 트랜잭션이 건드리는 참조만 잠그고, 현재 값이 작업자가 예상한 기존 값과 같은지 확인한다. 변경은 로그 복제본의 과반수가 기록한 뒤 보이게 된다. GitHub에 따르면 에이전트는 대체로 각자의 브랜치에 푸시하므로 이런 갱신을 병렬로 처리할 수 있다. 같은 참조를 두 푸시가 동시에 갱신하려 하면 하나만 로그에 추가된다. 처리량을 늘리는 설계가 같은 브랜치의 경쟁까지 없애 주는 것은 아니다.
별도 참조 서비스를 만든 데에는 읽기 비용도 작용했다. GitHub는 참조를 Blob Storage에서 관리하는 방식을 시험했다. 참조를 여러 Blob으로 나누자 쓰기 대기는 줄었지만, 읽을 때는 모든 조각의 변경 여부를 확인해야 했다. Ref-CAS에서는 복제본이 가진 버전이 최신이면 참조 데이터를 다시 보내지 않고 확인을 마친다.
많이 받아들인 뒤에도 읽기를 빠르게 유지하려면
푸시를 계속 받으면 팩도 계속 생긴다. Git은 여러 팩에 걸친 저장소를 읽을 수 있지만, 팩이 하나 늘 때마다 객체를 찾는 비용도 조금씩 커진다. 순간적으로 많은 쓰기를 받아내더라도 팩이 끝없이 쌓이면 이후 요청이 부담을 떠안는다.
이를 줄이는 작업이 압축 병합이다. 여러 팩을 더 적고 큰 팩으로 합쳐 관리한다. 기존 구조에서는 요청을 처리하는 복제본마다 이 작업도 수행했다. 새 구조는 별도 노드가 영속 저장소를 직접 다루도록 옮겼다. 가상 복제본의 CPU와 메모리를 요청 처리에 집중시키고, 유지보수 처리량은 유지보수 노드를 추가해 늘릴 수 있다.
압축 병합은 팩을 합치면서 모든 객체를 보존한다. 삭제한 브랜치나 강제 푸시 뒤에 남은 객체처럼 더는 참조되지 않는 객체를 없애는 일은 별도의 가비지 컬렉션이 맡는다. 팩의 수를 줄이는 작업과 필요 없는 객체를 지우는 작업은 역할이 다르다.
이렇게 요청 처리는 가상 복제본으로, 참조 변경의 순서 관리는 Ref-CAS로, 저장소 유지보수는 별도 노드로 나뉜다. 개발자는 기존처럼 푸시하고 가져오며 브랜치를 만든다. 달라지는 것은 그 요청을 받는 서버 안에서 각 일을 확장하는 방식이다. 11월 5일 발표 기준으로 새 구조는 제한적 비공개 프리뷰 단계이며, GitHub는 2027년 초 더 넓게 배포할 계획이라고 밝혔다.