작은 AI가 개인 비서 역할을 맡으려면 모든 답을 기억하는 능력 외에 필요한 기능을 골라 쓰는 능력이 필요하다. Tether AI Research가 2026년 11월 11일 발표한 BotPsy는 Qwen3.5-0.8B를 기반으로 도구 사용에 맞춰 후속 학습한 0.8B 파라미터 모델이다. 개발팀 발표는 기기 안에서 실행하는 비서를 목표로 삼는다.
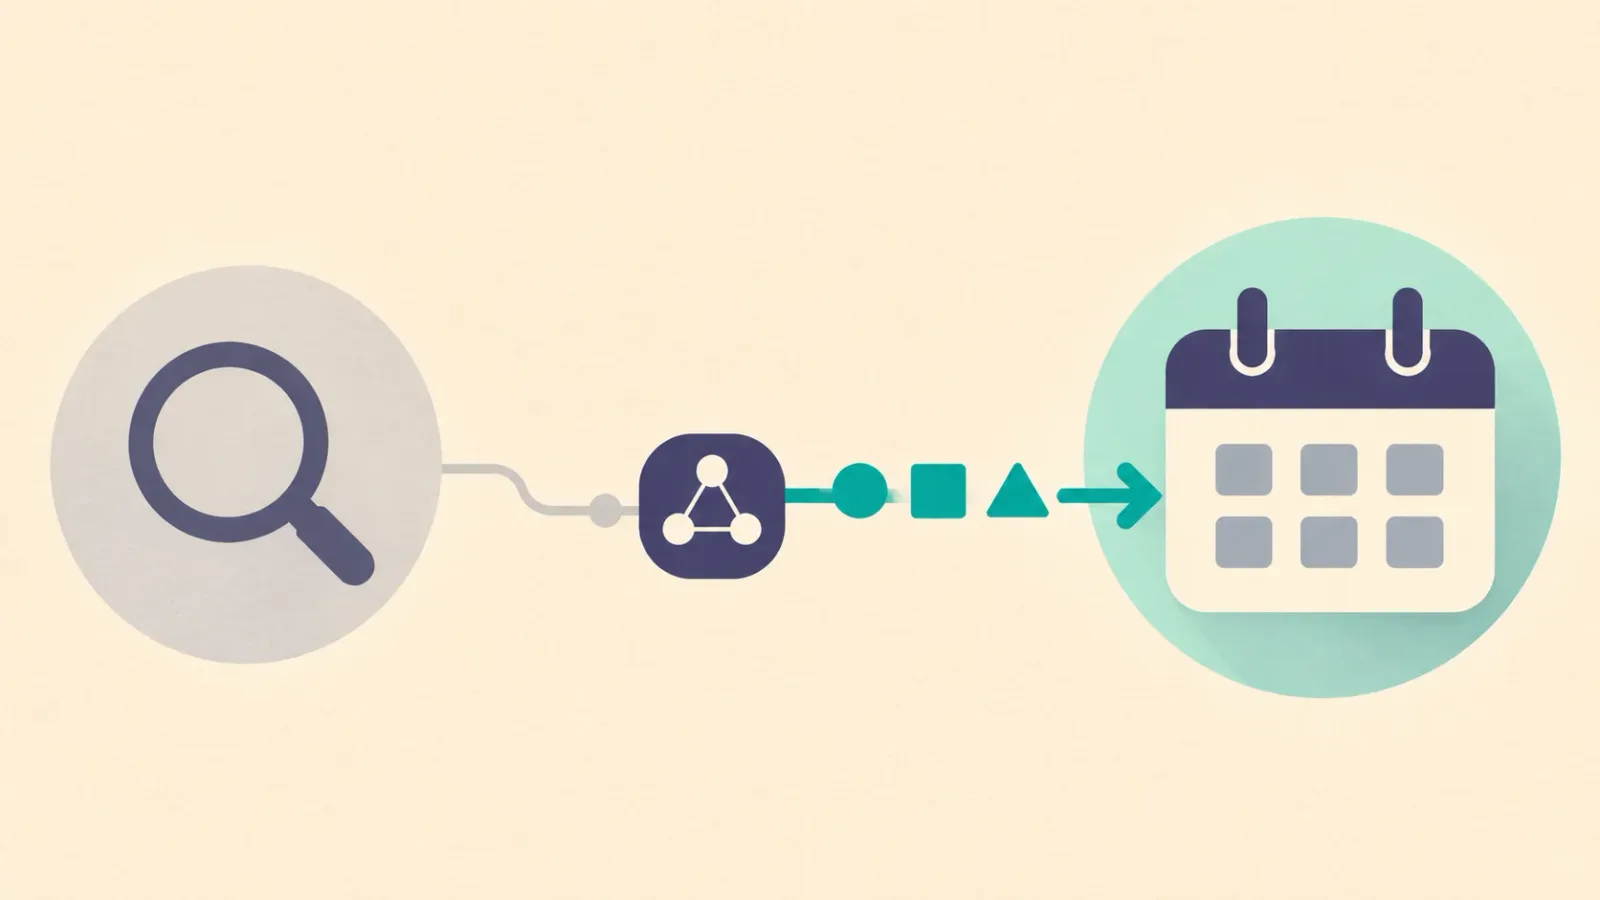
이 모델이 맡는 일은 사용자의 요청을 도구 호출로 바꾸는 것이다. 모델 카드의 예제는 ‘금요일 오후 3시에 치과 일정을 추가해 달라’는 요청에 일정 생성 함수와 제목·요일·시간을 전달하는 형태다. 모델은 어떤 기능에 어떤 정보를 넘길지 정하고, 연결된 프로그램이 그 호출을 실행하는 구조다. 이번 발표의 대상은 이런 역할을 맡을 모델이다.
도구 사용을 배우며 떨어진 능력까지 보완했다
개발팀은 먼저 도구 사용 대화를 시범으로 보여주는 지도 미세조정(SFT)을 진행했다. 여기에는 여러 차례 대화하며 작업하는 사례뿐 아니라 도구를 호출하지 말아야 할 사례도 포함했다. 개발팀에 따르면 이 단계에서 도구 사용 점수는 올랐지만, 지식과 지시 이행 능력은 기반 모델보다 낮아졌다.
이를 보완하기 위해 도구 사용, 일반 추론, 지시 이행에 각각 특화한 교사 모델을 활용했다. 작은 모델이 직접 응답을 생성하면 교사 모델이 토큰마다 피드백을 주는 증류 방식이다. 개발팀은 이 단계를 거치며 지식과 지시 이행 능력이 기반 모델 이상으로 회복됐고, 도구 사용 점수도 더 올랐다고 설명한다.
이후 두 차례 강화학습에서는 규칙과 검증기로 계산한 보상을 사용했다. 도구 호출에서는 함수 이름과 인자 이름·값이 정답과 얼마나 맞는지 평가해 부분 점수를 줬다. 뒤 단계에서는 수학과 코드, 지시 이행 등으로 학습 범위를 넓혔다. 도구 사용을 집중적으로 가르치면서 생긴 다른 능력의 저하를 회복하고, 검증 가능한 기준으로 응답을 더 다듬은 셈이다.
더 큰 모델보다 높은 점수와 남은 격차
개발팀 자체 평가에서 도구 사용 평가인 BFCL v4에서 BotPsy는 44.0점을 기록했다. 기반 모델인 Qwen3.5-0.8B-Think의 23.4점보다 높고, 더 큰 Qwen3.5-2B-Think의 37.7점도 앞섰다. 비교한 도구 사용·에이전트 평가 여섯 개 중 다섯 개에서 Qwen3.5-2B-Think보다 높았으며, Claw-Eval에서는 뒤졌다.
모델 카드에 따르면 비교 모델은 모두 같은 평가 도구에서 추론 모드로 실행했다. BotPsy는 BF16 가중치를 vLLM으로 구동했다. 이 조건의 평가 점수가 실제 스마트폰에서의 속도나 완전한 오프라인 동작까지 보여주는 것은 아니다.
개인 비서로 맡길 수 있는 일을 판단하려면 작업 복잡도에 따른 차이도 봐야 한다. 개발팀은 평가 시나리오를 한 번의 요청에 도구를 한 번 호출하는 단순 과제와, 여러 차례 대화하거나 여러 도구를 쓰는 복잡 과제로 나눴다.
| 개발팀의 시나리오별 평균 점수 | BotPsy | Qwen3.5-0.8B-Think | Qwen3.5-2B-Think |
|---|---|---|---|
| 단순 과제 | 75 | 54 | 70 |
| 복잡 과제 | 39.5 | 17.9 | 30.8 |
점수는 0~100 척도이며 각 범주에 속한 전체 시나리오의 평균이다. BotPsy의 복잡 과제 점수는 기반 모델과 더 큰 비교 모델보다 높지만, 단순 호출 점수와는 큰 차이가 난다. 특히 여러 단계를 거치는 정보 검색·조사 과제는 15점에 그쳤다. 이 범주에는 BrowseComp-Plus의 심층 조사 질문이 주로 포함됐다.
일반 지식 평가에서는 Qwen3.5-2B-Think가 앞섰다. 개발팀도 BotPsy를 모르는 사실을 도구로 찾도록 설계한 모델로 설명한다. 도구를 잘 선택하는 능력과, 조사에 필요한 여러 단계를 끝까지 수행하는 능력 사이에는 여전히 간격이 있다.
모델 카드는 BF16 가중치를 safetensors 형식으로 제공한다고 명시하고, llama.cpp와 QVAC SDK용 GGUF 저장소도 안내한다. 모델 라이선스는 Apache 2.0이다. 개발팀은 주로 영어로 학습·평가했으며 영어 사용을 권장한다. 금전·개인정보·건강처럼 민감한 주제를 다루는 응용과 고위험 자동 의사결정은 의도한 용도에서 제외한다.